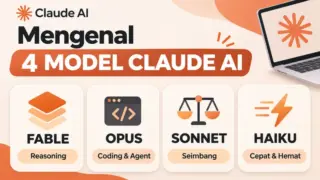
Anthropic memiliki dua model AI dengan kemampuan tinggi, yaitu Claude Opus 5.5 dan Claude Fable 5.2. Keduanya sama-sama mampu menangani coding kompleks, analisis mendalam, hingga pekerjaan AI Agent. Namun, kemampuan dan biaya penggunaannya ternyata cukup berbeda.
Claude Fable 5.2 merupakan model yang menawarkan kemampuan penalaran paling tinggi dalam jajaran model Claude yang tersedia secara umum. Sementara itu, Opus 5.5 justru menjadi model yang Anthropic rekomendasikan untuk sebagian besar pekerjaan.
Menariknya, harga API Fable 5.2 mencapai dua kali lipat Opus 5.5. Lalu, apakah kemampuan Fable memang jauh lebih pintar? Atau sebenarnya Opus sudah cukup untuk kebutuhan coding dan pekerjaan sehari-hari?
Untuk menjawabnya, saya akan membandingkan kemampuan, hasil benchmark, hingga biaya penggunaan kedua model tersebut berdasarkan data resmi Anthropic.
Mengenal Claude Opus 5.5 dan Fable 5.2
Sebelum membandingkan keduanya, kita perlu memahami posisi masing-masing model dalam keluarga Claude AI.
Anthropic merilis Claude Opus 5.5 pada 22 September 2026. Model ini dirancang untuk coding, pengembangan software, pekerjaan profesional, dan AI Agent yang menjalankan tugas dalam waktu lama.
Opus 5.5 juga membawa peningkatan efisiensi dibandingkan generasi sebelumnya. Anthropic mengklaim biaya penggunaan Opus 5.5 pada pekerjaan umum sekitar 40% lebih rendah daripada Opus 5.
Sementara itu, Claude Fable 5.2 hadir pada 9 November 2026. Anthropic mengembangkan model ini untuk menyelesaikan masalah teknis yang lebih menantang, termasuk pekerjaan ilmiah, coding kompleks, dan tugas yang memerlukan penalaran mendalam.
Secara sederhana, saya melihat perbedaan keduanya seperti ini:
Claude Opus 5.5 lebih mengutamakan keseimbangan antara kemampuan tinggi dan efisiensi. Sedangkan Claude Fable 5.2 menawarkan kemampuan tambahan untuk menangani masalah yang lebih sulit, meskipun biaya setiap tokennya lebih mahal.
Perbedaan tersebut penting karena tidak semua pekerjaan membutuhkan kemampuan model AI paling canggih.
Kalau ingin memahami posisi keduanya dalam keluarga Claude secara lebih luas, kamu juga bisa membaca artikel sebelumnya tentang 4 Model Claude AI: Fable, Opus, Sonnet dan Haiku.
Tabel Perbandingan Spesifikasi Claude Opus 5.5 vs Fable 5.2
Berikut spesifikasi kedua model berdasarkan dokumentasi resmi Anthropic per November 2026.
| Spesifikasi | Claude Opus 5.5 | Claude Fable 5.2 |
|---|---|---|
| Tanggal rilis | 22 September 2026 | 9 November 2026 |
| Fokus utama | Coding, AI Agent, pekerjaan profesional | Reasoning kompleks, riset, AI Agent |
| Context window | 1 juta token | 1 juta token |
| Maksimum output | 128 ribu token | 128 ribu token |
| Adaptive thinking | Ya | Ya |
| Default effort API | Medium | High |
| Input API / 1 juta token | US$4 | US$8 |
| Output API / 1 juta token | US$20 | US$40 |
Dari tabel tersebut, terlihat bahwa Opus 5.5 dan Fable 5.2 memiliki beberapa spesifikasi dasar yang sama.
Keduanya mendukung context window hingga 1 juta token dan maksimum output 128 ribu token. Artinya, kedua model memiliki kapasitas konteks yang besar untuk membaca dokumen panjang, source code, maupun informasi dari banyak file.
Namun, ukuran context window tidak menentukan seberapa pintar sebuah model.
Perbedaan kemampuan keduanya lebih terlihat ketika harus menyelesaikan persoalan yang membutuhkan penalaran kompleks atau mengerjakan tugas bertahap.
Ada satu detail menarik lainnya, yaitu pengaturan effort.
Opus 5.5 menggunakan tingkat effort Medium secara default, sedangkan Fable 5.2 menggunakan High. Pengaturan ini memengaruhi seberapa besar upaya penalaran yang dilakukan model, termasuk latensi dan jumlah token yang digunakan.
Karena itu, membandingkan kedua model hanya berdasarkan harga token atau pengaturan default belum cukup untuk menentukan mana yang lebih efisien.
Perbandingan Benchmark: Apakah Fable 5.2 Lebih Pintar?
Untuk mengetahui kemampuan kedua model, kita bisa melihat hasil benchmark yang Anthropic publikasikan ketika memperkenalkan Fable 5.2.
Benchmark merupakan pengujian untuk mengukur kemampuan AI dalam menyelesaikan tugas tertentu.
Berikut beberapa hasil benchmark Claude Opus 5.5 dan Fable 5.2.
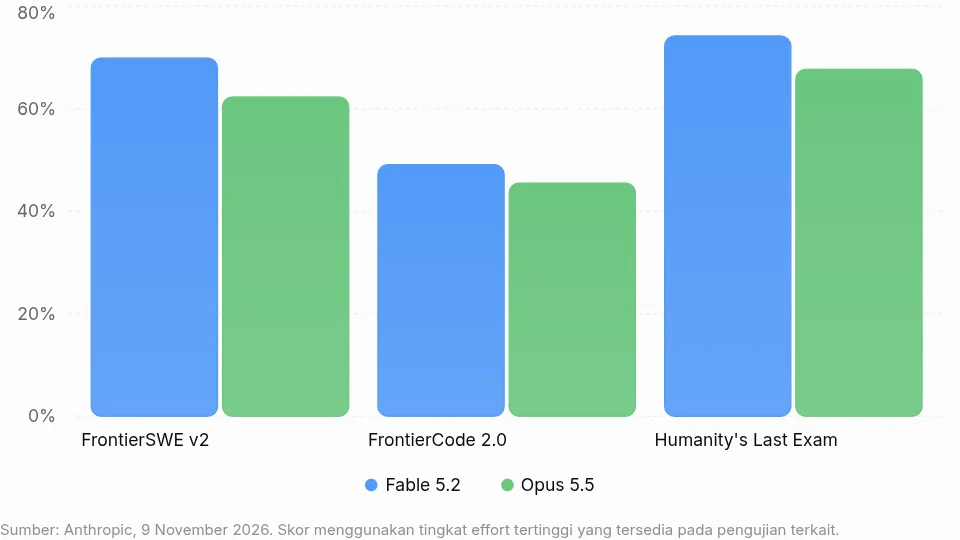
| Benchmark | Opus 5.5 | Fable 5.2 |
|---|---|---|
| FrontierSWE v2 | 62,3% | 69,9% |
| FrontierCode 2.0 | 45,5% | 49,1% |
| AutomationBench | 42,5% | 51,4% |
| Terminal-Bench-Science 0.1 | 58,7% | 74,6% |
Sumber: Anthropic — Claude Fable. Hasil menggunakan konfigurasi evaluasi yang dipublikasikan Anthropic, dengan tingkat effort sesuai pengujian masing-masing. Skor bukan hasil pengujian langsung oleh LhaGeek.
1. FrontierSWE v2: Fable Unggul 7,6 Poin
FrontierSWE v2 menguji kemampuan model AI dalam menyelesaikan tugas rekayasa perangkat lunak.
Claude Fable 5.2 memperoleh skor 69,9%, sedangkan Opus 5.5 mencapai 62,3%.
Selisihnya mencapai 7,6 poin persentase.
Ini menunjukkan keunggulan Fable dalam menyelesaikan tugas software engineering pada pengujian tersebut.
Tetapi bukan berarti setiap pekerjaan coding menggunakan Fable otomatis menghasilkan kode yang lebih bagus.
Untuk perubahan kode sederhana, memperbaiki fungsi PHP, atau membuat komponen website, kemampuan tambahan Fable mungkin tidak terlalu terasa.
2. FrontierCode 2.0: Selisihnya Tidak Terlalu Jauh
Pada benchmark FrontierCode 2.0, Claude Fable 5.2 memperoleh skor 49,1%, sementara Opus 5.5 mencapai 45,5%.
Selisihnya sekitar 3,6 poin persentase.
Dibandingkan hasil FrontierSWE v2, jarak kemampuan kedua model pada pengujian ini terlihat lebih kecil.
Menurut saya, hasil tersebut menarik karena menunjukkan bahwa Opus 5.5 masih mampu bersaing dengan Fable dalam tugas coding yang sulit.
Tentunya, hasil akhirnya tetap bergantung pada jenis pekerjaan dan konfigurasi pengujian.
3. AutomationBench: Fable Lebih Unggul untuk Workflow Kompleks
Perbedaan yang lebih besar terlihat pada AutomationBench.
Claude Fable 5.2 mencatat skor 51,4%, sementara Opus 5.5 memperoleh 42,5%.
Selisihnya mencapai 8,9 poin persentase.
Benchmark ini berkaitan dengan kemampuan menyelesaikan workflow bisnis dan tugas otomatisasi.
Hasil tersebut menjadi salah satu alasan Fable menarik untuk pekerjaan yang melibatkan banyak tahapan, penggunaan tool, dan pengambilan keputusan secara berurutan.
Namun, perlu diingat bahwa semua benchmark memiliki keterbatasan. Skor lebih tinggi pada satu pengujian tidak menjamin hasil lebih baik untuk setiap kasus penggunaan.
Claude Opus vs Fable untuk Coding, Bagus Mana?
Kalau tujuan utamanya untuk coding, menurut saya kedua model ini sebenarnya sama-sama menarik.
Perbedaannya lebih terasa ketika kita melihat tingkat kesulitan pekerjaan yang ingin diselesaikan.
Opus 5.5 Sudah Sangat Layak untuk Coding Harian
Misalnya kita sedang mengembangkan website WordPress dan membutuhkan bantuan Claude untuk:
- Membuat plugin WordPress.
- Menambahkan fitur baru pada aplikasi PHP.
- Memperbaiki error JavaScript.
- Melakukan refactoring beberapa file.
- Membuat integrasi API.
- Menulis unit test dan dokumentasi kode.
Untuk kebutuhan seperti ini, saya akan mencoba Opus 5.5 terlebih dahulu.
Alasannya bukan karena Fable tidak cocok, tetapi karena Opus sudah menawarkan kemampuan coding yang tinggi dengan biaya API lebih rendah.
Jika pekerjaan selesai dengan hasil yang sesuai, tidak ada alasan kuat untuk langsung berpindah ke Fable.
Fable 5.2 Lebih Menarik untuk Masalah yang Sulit
Sekarang bayangkan kita memiliki aplikasi besar dengan ribuan file.
Aplikasi tersebut menggunakan beberapa layanan eksternal, memiliki banyak ketergantungan, dan membutuhkan perubahan arsitektur tanpa merusak fungsi sebelumnya.
Pada situasi seperti ini, model AI perlu memahami hubungan antarbagian sistem, mempertimbangkan berbagai risiko, dan menguji perubahan secara bertahap.
Claude Fable 5.2 menjadi pilihan yang lebih menarik karena Anthropic memang merancangnya untuk pekerjaan kompleks dan berdurasi panjang.
Fable juga bisa menjadi alternatif ketika Opus sudah mencoba berbagai pendekatan tetapi belum berhasil menemukan solusi yang tepat.
Meski demikian, hasil coding dari kedua model tetap perlu menjalani pengujian. Model yang lebih pintar sekalipun masih bisa menghasilkan bug, salah memahami kebutuhan, atau membuat perubahan yang tidak diinginkan.
Perbandingan Opus dan Fable untuk AI Agent
Selain coding, perbedaan keduanya juga menarik jika digunakan sebagai otak AI Agent.
AI Agent merupakan sistem yang menggunakan model AI untuk menjalankan tugas melalui serangkaian langkah, termasuk memanggil tool atau mengakses aplikasi tertentu.
Sebagai contoh, kita ingin membuat AI Agent untuk mengelola beberapa website.
Tugasnya meliputi memeriksa kondisi server, membaca laporan error, mengecek backup, menganalisis masalah, dan membuat rekomendasi perbaikan.
Untuk pekerjaan operasional seperti ini, Opus 5.5 bisa menjadi pilihan yang cukup masuk akal, terutama jika workflow sudah jelas dan agent mempunyai tool yang sesuai.
Sementara itu, Fable 5.2 lebih menarik ketika AI Agent menghadapi pekerjaan yang sulit diprediksi.
Misalnya agent harus menyelesaikan migrasi sistem besar, menelusuri masalah pada banyak komponen, atau melakukan riset yang memerlukan beberapa tahapan analisis.
Dalam dokumentasinya, Anthropic secara khusus menempatkan Fable untuk long-horizon agentic work, yaitu pekerjaan AI Agent yang berjalan melalui proses panjang.
Namun, menurut saya hal terpenting bukan sekadar memilih model paling canggih.
Kualitas AI Agent juga bergantung pada desain workflow, akses tool, pengaturan izin, dan proses verifikasi hasilnya.
Untuk pekerjaan yang berisiko, seperti perubahan server produksi atau penghapusan data, tetap diperlukan pengawasan dan persetujuan pengguna.
Harga Claude Fable Dua Kali Opus, Apakah Sepadan?
Inilah salah satu bagian paling menarik dari perbandingan Claude Opus 5.5 vs Fable 5.2.
Anthropic menetapkan tarif dasar API sebagai berikut.
| Biaya | Opus 5.5 | Fable 5.2 |
|---|---|---|
| 1 juta token input | US$4 | US$8 |
| 1 juta token output | US$20 | US$40 |
Secara sederhana, tarif Fable memang dua kali lebih mahal.
Tetapi apakah biaya menyelesaikan satu pekerjaan juga pasti dua kali lipat?
Belum tentu.
Contoh Perhitungan Biaya API
Misalnya kita mempunyai pekerjaan dengan konsumsi:
- Input: 100.000 token.
- Output: 20.000 token.
Berikut gambaran biaya jika kedua model memakai jumlah token yang sama.
| Perhitungan | Opus 5.5 | Fable 5.2 |
|---|---|---|
| Biaya input | US$0,40 | US$0,80 |
| Biaya output | US$0,40 | US$0,80 |
| Total | US$0,80 | US$1,60 |
Perhitungan tersebut menggunakan tarif standar tanpa prompt caching, penggunaan tool berbayar, maupun biaya tambahan lainnya.
Dengan konsumsi token yang sama, jelas Fable membutuhkan biaya dua kali lebih besar.
Tetapi ada satu hal yang perlu diperhatikan.
Model dengan harga per token lebih mahal belum tentu selalu lebih mahal untuk menyelesaikan suatu pekerjaan.
Dalam pengujian FrontierCode 2.0 yang Anthropic publikasikan, Fable 5.2 pada effort High menghasilkan skor yang kurang lebih setara dengan Opus 5.5 pada effort Max, tetapi menggunakan sekitar setengah biaya per tugas.
Artinya, peningkatan kemampuan dan pengaturan effort bisa mengubah perbandingan biaya secara signifikan.
Meski demikian, hasil pengujian tersebut tidak otomatis berlaku untuk setiap pekerjaan coding.
Kalau ingin mengetahui model yang benar-benar hemat untuk kebutuhan sendiri, kita perlu membandingkan biaya total hingga pekerjaan selesai, bukan sekadar harga per juta token.
Kapan Sebaiknya Memilih Opus 5.5 dan Fable 5.2?
Berdasarkan kemampuan, benchmark, dan biaya yang sudah dibahas, saya menyarankan pendekatan berikut.
| Kebutuhan | Model yang saya pilih |
|---|---|
| Coding WordPress dan PHP | Opus 5.5 |
| Debugging aplikasi sehari-hari | Opus 5.5 |
| Membuat aplikasi dengan kebutuhan jelas | Opus 5.5 |
| Refactoring codebase sangat besar | Fable 5.2 |
| Menyelesaikan masalah coding yang sangat rumit | Fable 5.2 |
| AI Agent operasional | Opus 5.5 |
| AI Agent dengan tugas kompleks dan panjang | Fable 5.2 |
| Riset teknis mendalam | Fable 5.2 |
Tabel tersebut bukan berarti Opus tidak mampu mengerjakan tugas kompleks atau Fable tidak cocok untuk pekerjaan sederhana.
Keduanya tetap bisa digunakan secara fleksibel.
Namun, jika kita ingin mempertimbangkan efisiensi, saya lebih menyukai pendekatan memulai dari model yang cukup untuk menyelesaikan pekerjaan, lalu meningkatkan kemampuan model ketika memang diperlukan.
Untuk developer, pendekatan ini bisa membantu mengontrol penggunaan token sekaligus menjaga kualitas hasil.
Apakah Claude Fable 5.2 Bisa Digunakan Gratis?
Claude Fable 5.2 tidak tersedia pada paket Free.
Anthropic menyediakan akses Fable melalui paket berbayar, termasuk Pro, Max, Ultra, Team, dan Enterprise, dengan ketentuan penggunaan yang berbeda.
Ketersediaan model melalui aplikasi Claude juga tidak sama dengan biaya API.
Pengguna yang mengakses Fable melalui Claude Pro dapat dikenai penggunaan kredit tambahan sesuai ketentuan paket, sementara paket lain menawarkan alokasi akses yang berbeda.
Jadi, sebelum berlangganan hanya untuk menggunakan Fable, sebaiknya periksa dahulu batas pemakaian dan ketentuan terbaru di akun Claude masing-masing.
Informasi selengkapnya bisa dilihat melalui Claude Help Center.
Kesimpulan: Fable Lebih Pintar, tetapi Opus Bisa Lebih Worth It
Dari hasil benchmark resmi Anthropic, Claude Fable 5.2 memang menunjukkan kemampuan lebih tinggi dibandingkan Opus 5.5 dalam beberapa pengujian coding, workflow, dan riset ilmiah.
Namun, keunggulan tersebut tidak otomatis membuat Fable menjadi pilihan terbaik untuk semua pengguna.
Claude Opus 5.5 masih menawarkan kemampuan yang sangat tinggi untuk coding, AI Agent, dan pekerjaan profesional. Bahkan Anthropic sendiri merekomendasikan Opus sebagai titik awal untuk sebagian besar pekerjaan.
Sementara itu, Fable lebih cocok ketika kita menghadapi masalah yang benar-benar kompleks atau membutuhkan kemampuan penalaran tambahan.
Kalau saya harus memilih untuk pekerjaan coding sehari-hari, Opus 5.5 akan menjadi pilihan pertama. Selain lebih ekonomis, kemampuannya sudah memadai untuk banyak pekerjaan pengembangan software.
Tetapi jika Opus mulai kesulitan menyelesaikan tugas yang rumit, barulah saya akan mempertimbangkan Fable 5.2.
Jadi, bukan berarti model AI paling mahal selalu menjadi pilihan terbaik. Yang lebih penting adalah seberapa efektif model tersebut menyelesaikan pekerjaan dengan biaya dan waktu yang masuk akal.
Disclaimer : Data spesifikasi, benchmark, dan harga mengacu pada informasi resmi Anthropic yang tersedia per 17 November 2026.