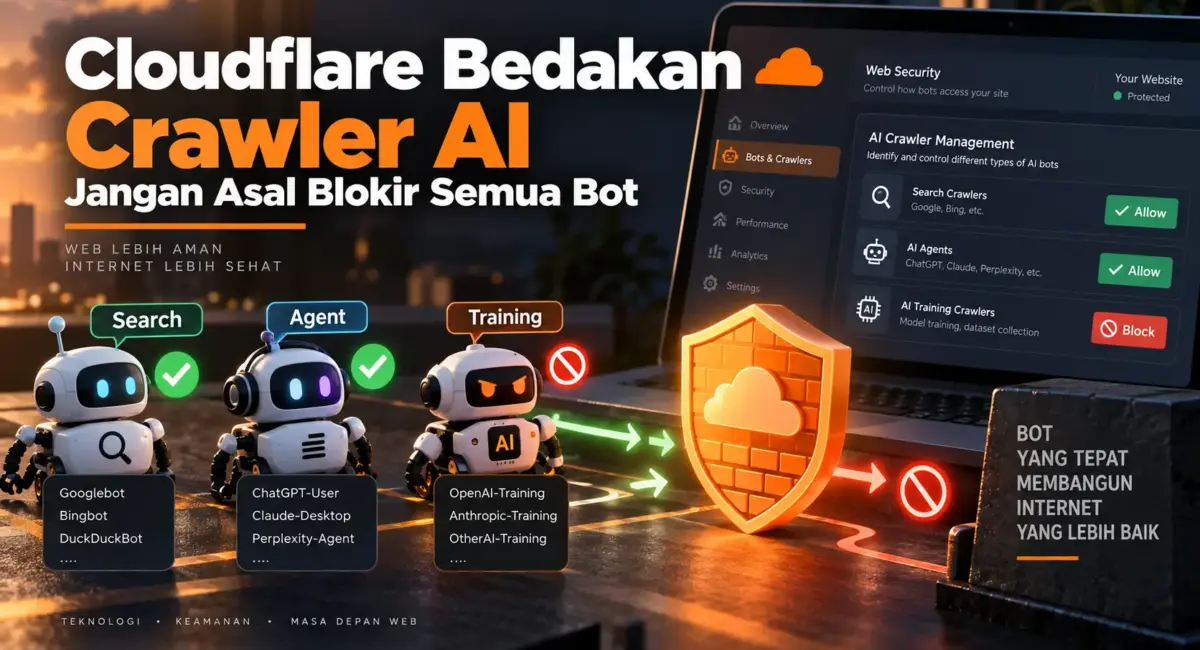
Cloudflare kembali mengubah cara pemilik website mengatur trafik dari bot dan crawler AI. Mulai 15 September 2026, Cloudflare tidak lagi melihat semua bot AI sebagai kelompok yang sama, tetapi mulai membedakannya berdasarkan tujuan mereka ketika mengakses sebuah website.
Menurut saya, perubahan ini cukup penting untuk diperhatikan, terutama bagi pemilik blog, website berita, hingga website bisnis yang memakai Cloudflare. Pasalnya, kebiasaan memblokir semua bot AI sekaligus sekarang justru berpotensi membuat website kehilangan peluang trafik dari mesin pencari maupun layanan AI Search.
Cloudflare membagi aktivitas bot AI menjadi tiga kelompok utama, yaitu Search, Agent, dan Training. Pemilik website kemudian bisa menentukan jenis crawler mana yang tetap boleh masuk dan mana yang ingin diblokir.
Cloudflare Tidak Lagi Menganggap Semua Crawler AI Sama
Selama beberapa tahun terakhir, crawler AI memang menjadi masalah baru bagi banyak pemilik website. Konten yang dibuat berjam-jam bisa diambil crawler untuk kebutuhan model AI, sementara trafik yang dikembalikan ke website belum tentu sebanding.
Cloudflare sebelumnya menyediakan fitur Block AI Bots yang membuat pemilik website lebih mudah menghentikan crawler AI. Namun perkembangan AI membuat definisi “bot AI” semakin kompleks, karena ternyata tidak semua crawler memiliki tujuan yang sama.
Ada crawler yang mengambil konten untuk melatih model AI, tetapi ada juga crawler yang bekerja seperti mesin pencari dan berpotensi mengirimkan pengguna kembali ke website. Karena itulah Cloudflare sekarang mencoba memisahkan trafik tersebut berdasarkan aktivitasnya.
Sekarang Ada Search, Agent, dan Training
Cloudflare membagi tiga aktivitas AI yang bisa dikontrol pemilik website menjadi Search, Agent, dan Training.
Search merupakan crawler yang mengumpulkan atau mengindeks informasi agar konten website nantinya bisa ditemukan melalui pencarian. Jenis crawler seperti ini memiliki karakter yang relatif dekat dengan crawler mesin pencari karena masih berpotensi menghasilkan referral atau kunjungan kembali ke website.
Agent berbeda lagi. Bot ini bekerja secara real-time mewakili pengguna, misalnya ketika sebuah AI assistant diminta membuka halaman website, mencari informasi tertentu, atau melakukan aktivitas menggunakan browser.
Sedangkan Training merupakan crawler yang mengakses konten untuk kebutuhan pelatihan atau penyempurnaan model AI. Data yang diambil berpotensi menjadi bagian dari pengetahuan model dan tidak selalu menghasilkan kunjungan pengguna kembali ke website.
Menurut saya pembagian seperti ini jauh lebih masuk akal dibanding sekadar pilihan “izinkan AI” atau “blokir AI”. Pemilik website akhirnya punya kontrol lebih jelas terhadap tujuan crawler yang mengakses kontennya.
Mulai 15 September 2026, Default Cloudflare Ikut Berubah
Yang membuat perubahan ini kembali menarik perhatian adalah tanggal penerapannya. Cloudflare sebelumnya mengumumkan bahwa mulai 15 September 2026, konfigurasi default untuk domain baru akan berubah.
Crawler yang masuk kategori Training dan Agent akan diblokir secara default pada halaman yang menampilkan iklan, sementara crawler Search tetap diperbolehkan. Cloudflare menilai halaman beriklan biasanya mengandalkan perhatian dan kunjungan manusia sebagai bagian dari model bisnis pemilik website.
Cloudflare juga menyatakan perubahan default tersebut berlaku pada existing Free customers yang sebelumnya belum menentukan sendiri preferensinya. Karena itu, pengguna Cloudflare Free sebaiknya mulai memeriksa kembali konfigurasi bot masing-masing daripada sekadar membiarkan konfigurasi default tanpa mengetahui dampaknya.
Masalahnya, Ada Crawler yang Punya Lebih dari Satu Fungsi
Nah, bagian inilah yang menurut saya paling penting untuk pemilik blog dan website yang mengandalkan SEO.
Tidak semua crawler hanya melakukan satu pekerjaan. Ada multi-purpose crawler yang dapat menjalankan aktivitas Search sekaligus Training, sehingga satu bot bisa mendapatkan lebih dari satu klasifikasi.
Cloudflare mengatakan bahwa crawler seperti ini akan mengikuti aturan paling ketat yang diterapkan pemilik website. Artinya, ketika sebuah crawler memiliki fungsi Search sekaligus Training kemudian kita memilih memblokir kategori Training, crawler tersebut berpotensi ikut terblokir.
Cloudflare bahkan secara khusus menyebut Googlebot, Applebot, dan BingBot sebagai contoh crawler multi-purpose dalam penjelasan mereka. Jadi jangan sampai niat awal kita hanya ingin menghentikan scraping untuk AI training, tetapi tanpa disadari malah ikut mengganggu crawler yang dibutuhkan untuk discovery atau pencarian.
Ini bukan berarti semua pengguna Cloudflare pasti otomatis kehilangan indexing Google. Konfigurasinya tetap bergantung pada aturan yang digunakan masing-masing domain, tetapi perubahan ini cukup menjadi alasan untuk tidak asal menyalakan semua opsi Block tanpa membaca kategorinya terlebih dahulu.
Jadi Jangan Asal Blokir Semua Bot AI
Beberapa tahun lalu mungkin masih cukup mudah mengatakan, “Saya tidak ingin konten dipakai AI, jadi blokir saja semuanya.”
Sekarang kondisinya sudah berbeda. AI mulai menjadi salah satu cara pengguna menemukan informasi di internet, sehingga crawler dari layanan AI Search berpotensi menjadi sumber discovery baru selain Google dan Bing.
Sebagai pemilik website, menurut saya kita perlu melihat fungsi crawler, bukan hanya melihat apakah crawler tersebut berhubungan dengan AI atau tidak.
Crawler Training yang hanya mengambil konten untuk melatih model mungkin memang ingin kita blokir. Sebaliknya, crawler Search yang berpotensi menampilkan sumber, kutipan, dan link menuju artikel kita bisa saja tetap layak mendapatkan akses.
Pendekatan Cloudflare sendiri kurang lebih mengarah ke sana. Dokumentasinya bahkan menyebut pemilik website dapat mengizinkan crawler yang memberikan manfaat berupa citation, referral, atau memiliki kesepakatan tertentu, sambil tetap memblokir crawler yang perilakunya tidak sesuai dengan strategi konten website.
Pemilik Website Bisa Cek Crawler yang Masuk
Cloudflare sebenarnya sudah menyediakan fitur AI Crawl Control untuk membantu melihat aktivitas crawler AI pada sebuah domain.
Di sana kita bisa mengetahui crawler apa yang mengakses website, operatornya, jumlah request, kategori crawler hingga apakah crawler tersebut melanggar aturan robots.txt. Pengguna kemudian dapat menentukan crawler tertentu untuk diizinkan atau diblokir.
Contohnya, Cloudflare mengenali beberapa crawler AI dengan fungsi yang berbeda. OpenAI memiliki GPTBot, ChatGPT-User dan OAI-SearchBot, sedangkan Anthropic memiliki ClaudeBot, Claude-SearchBot dan Claude-User. Perplexity juga memiliki PerplexityBot dan Perplexity-User.
Nama-nama tersebut menunjukkan mengapa memblokir berdasarkan nama perusahaan saja sudah kurang ideal. Satu perusahaan AI bisa memiliki crawler khusus pencarian, crawler untuk assistant, dan crawler dengan fungsi lainnya.
robots.txt Saja Belum Tentu Cukup
Pemilik website juga tetap bisa menggunakan robots.txt untuk memberi tahu crawler mengenai konten mana yang boleh atau tidak boleh diakses. Namun Cloudflare mengingatkan bahwa kepatuhan terhadap robots.txt pada dasarnya bersifat sukarela.
Crawler yang patuh akan mengikuti instruksi tersebut, tetapi secara teknis robots.txt bukan firewall yang benar-benar menghentikan request. Jika membutuhkan pemblokiran nyata, Cloudflare menyarankan menggunakan AI Crawl Control atau aturan keamanan lainnya.
Cloudflare sendiri juga mulai mengembangkan pendekatan yang lebih detail melalui Content Signals. Salah satu idenya adalah memungkinkan website menyatakan bahwa konten boleh digunakan untuk search tetapi tidak untuk AI training.
Konsep tersebut menurut saya jauh lebih menarik untuk masa depan web dibanding sekadar pilihan “boleh crawl” atau “tidak boleh crawl”.
AI Search Bisa Menjadi Sumber Trafik Baru
Ada alasan lain mengapa saya kurang menyarankan pemilik blog langsung memblokir semua crawler AI.
Perilaku pengguna internet mulai berubah. Banyak orang sekarang mencari informasi melalui ChatGPT, Perplexity, Gemini, Claude, dan layanan AI lainnya sebelum atau bahkan tanpa membuka Google Search seperti biasanya.
Dalam laporan Cloudflare, perubahan ini bahkan disebut sebagai bagian dari pergeseran menuju agentic Internet. Cloudflare mencatat bahwa 52 persen request crawler yang mereka identifikasi pada Juni 2026 berkaitan dengan AI training, sementara lebih dari 36 persen aktivitas berasal dari crawler dengan penggunaan campuran.
Angka tersebut menunjukkan betapa besarnya trafik non-manusia yang sekarang mengakses website.
Bagi blogger, tantangannya tentu mencari titik tengah. Kita ingin melindungi konten agar tidak sekadar disedot untuk training, tetapi di sisi lain jangan sampai menutup jalur yang justru bisa membuat artikel ditemukan melalui AI Search.
Apa yang Sebaiknya Dilakukan Pengguna Cloudflare?
Kalau website Anda menggunakan Cloudflare, saya rasa sekarang saat yang tepat untuk membuka kembali pengaturan bot yang sebelumnya mungkin jarang disentuh.
Masuk ke bagian pengaturan keamanan Cloudflare dan periksa AI bot policies serta AI Crawl Control. Jangan langsung memilih Block untuk seluruh kategori sebelum mengetahui crawler mana yang sebenarnya mengakses website dan apa fungsi crawler tersebut.
Untuk blog yang mengandalkan SEO dan trafik organik seperti LhaGeek, pendekatan yang menurut saya lebih masuk akal adalah tetap membuka akses crawler yang berfungsi untuk Search, kemudian lebih selektif terhadap Training dan Agent.
Tentunya konfigurasi terbaik bisa berbeda untuk setiap website. Website dokumentasi open source, portal berita, toko online, blog dengan AdSense, dan website membership berbayar memiliki kebutuhan yang tidak sama.
Pemilik Website Sekarang Harus Lebih Selektif
Perubahan Cloudflare ini menunjukkan bahwa era memandang semua bot sebagai trafik yang sama mulai berakhir. Kita sekarang bukan hanya perlu membedakan manusia dan bot, tetapi juga harus mengetahui apa tujuan bot tersebut datang ke website kita.
Bagi saya, fitur granular seperti Search, Agent, dan Training justru memberi keuntungan bagi pemilik website. Kita bisa tetap menjaga peluang mendapatkan trafik dan citation dari AI Search sambil membatasi crawler yang hanya mengambil konten untuk kebutuhan training.
Jadi kalau Anda menggunakan Cloudflare dan sebelumnya mengaktifkan opsi pemblokiran AI, ada baiknya cek kembali konfigurasinya setelah perubahan 15 September 2026 ini. Jangan sampai karena ingin mencegah satu jenis crawler, kita justru memblokir bot yang masih memiliki peran penting terhadap visibility website di mesin pencari dan ekosistem AI Search.